Analyse Vidéo par LLM & Cut Valet : Du Motion à l’Indexation Sémantique de Cut Valet
Pendant des décennies, le dérushage et le catalogage des flux vidéo représentaient le goulet d’étranglement majeur de la post-production et de la gestion d’archives audiovisuelles (MAM). Les flux de travail reposaient sur une saisie fastidieuse de métadonnées manuelles, limitée à quelques tags globaux, un timecode approximatif et, dans le meilleur des cas, une reconnaissance faciale basique. L’émergence des modèles de fondation multimodaux de grande taille (MLLM) et l’arrivée d’architectures spécialisées comme Cut Valet ont pulvérisé ces contraintes.
Désormais, un fichier vidéo n’est plus perçu par la machine comme un assemblage opaque de trames compressées, mais comme un espace spatio-temporel vectoriel complet. De la décomposition du mouvement (motion vectors et flux optique) à la transcription alignée phonétiquement, en passant par l’OCR intra-image et l’interprétation contextuelle des scènes, l’intelligence artificielle est devenue capable de regarder, d’écouter, d’indexer et d’anticiper le montage. Plongée au cœur de ces technologies qui redéfinissent l’indexation média.
1. Les Fondations Techniques : Comment un LLM Ingère et Comprend la Vidéo
Pour comprendre la portée de ces outils de catalogage, il faut d’abord démystifier la manière dont les modèles de langage traitent une vidéo. Un fichier vidéo 4K à 24 ou 60 images par seconde génère une quantité phénoménale de données brutes. Aucun modèle d’IA ne peut injecter chaque pixel de chaque trame directement dans sa couche d’attention sans saturer instantanément la mémoire VRAM de ses clusters de calcul.
L’ingestion moderne repose sur une tokenisation visuelle dynamique combinée à des fenêtres de contexte gigantesques :
- L’échantillonnage temporel intelligent : Plutôt que d’analyser toutes les images (ce qui saturerait le contexte inutilement), le pipeline découpe le flux en séquences clés. Les modèles échantillonnent la vidéo à des fréquences variables (généralement entre 1 et 4 trames par seconde), adaptées dynamiquement en fonction du rythme des transitions et de la vitesse de la caméra.
- La projection en patchs (Vision Transformers – ViT) : Chaque trame sélectionnée est subdivisée en grille de patchs (par exemple 14×14 ou 16×16 pixels). Ces patchs sont aplatis, projetés linéairement et convertis en tokens visuels via un encodeur d’image pré-entraîné (comme SigLIP ou CLIP).
- Le couplage spatio-temporel : Les tokens d’image ne sont pas traités isolément. Des encodages de position temporelle (Rotary Position Embeddings – RoPE) permettent au LLM de comprendre non seulement la position spatiale d’un objet dans le cadre, mais aussi sa persistance et sa trajectoire au fil du temps.
- La fenêtre de contexte géante : Grâce aux architectures récentes dotées de contextes de 1 à 2 millions de tokens (famille Gemini 1.5 et 2.0, Claude 3.5 Sonnet ou GPT-4o), il devient possible d’injecter des dizaines de minutes, voire plusieurs heures de vidéo nativement dans un même prompt d’évaluation sans perte de mémoire à long terme.
2. L’Analyse du Mouvement : Flux Optique, Trajectoire et Dynamique de Caméra
L’un des défis les plus ardus pour l’IA visuelle réside dans la distinction entre le mouvement des sujets dans le cadre et le mouvement de l’appareil de prise de vue lui-même. C’est précisément sur ce point que Cut Valet et les pipelines de catalogage avancés font la différence en articulant des couches d’analyse vectorielle spécialisées en amont du LLM.
Détection des mouvements d’appareil (Camera Motion Classification)
Grâce à l’analyse différentielle des trames successives et au calcul du flux optique (Optical Flow), le système segmente les vecteurs de déplacement globaux. Il catégorise instantanément les techniques cinématographiques employées :
- Panoramique horizontal (Pan) et vertical (Tilt) : Mesure de la translation angulaire de la caméra sur son axe.
- Travelling et Dolly : Identification des variations de parallaxe entre le premier plan et l’arrière-plan, attestant d’un déplacement physique de la caméra dans l’espace.
- Zoom (optique vs numérique) : Détection de l’expansion ou de la contraction concentrique des vecteurs de mouvement sans modification de perspective géométrique.
- Stabilité et support : Qualification du mouvement (plan fixe sur trépied, travelling fluide sur rail/gimbal, caméra à l’épaule ou mouvements brusques de caméra embarquée).
Trajectoire des objets et cinématique des sujets
En parallèle du mouvement de caméra, l’analyse isole les entités mobiles (acteurs, véhicules, animaux) via des algorithmes de suivi d’objets (Object Tracking multi-cibles). Le système enregistre :
- Le vecteur directionnel d’entrée et de sortie de champ (ex. : « Entrée côté cour, sortie côté jardin »).
- La vitesse relative et l’intensité de l’action (course, marche, geste précis, choc physique).
- La rupture de mouvement : arrêt soudain, accélération brutale ou hésitation gestuelle.
Ces données de cinématique ne restent pas cantonnées à des valeurs scalaires abstraites : elles sont traduites en métadonnées textuelles précises pour le modèle de langage, rendant possibles des requêtes telles que : « Trouve-moi un plan où la caméra avance en contre-plongée pendant que le personnage principal se retourne vivement vers l’objectif. »
https://digital.heliada.live/wp-content/uploads/placeholder-motion-vectors-optical-flow-analysis.jpg
3. L’Audio Multicouche : Transcription, Prosodie et Acoustique Environnementale
L’image ne raconte que la moitié de l’histoire. L’indexation multimodale de pointe traite le signal audio non pas comme un simple sous-titre généré à la volée, mais comme un gisement sémantique à plusieurs niveaux de lecture.
Transcription phonétique et alignement timecode au mot près
À l’aide d’architectures ASR (Automatic Speech Recognition) comme Whisper ou des encodeurs audio natifs des grands LLM, la parole est transcrite avec un ancrage temporel précis à la milliseconde près (Word-level timestamps). Cela garantit :
- Le repérage immédiat de citations exactes.
- La gestion du multilinguisme et la détection automatique des dialectes ou jargons techniques.
- La diarisation des locuteurs : savoir avec certitude qui parle à quel moment, même en cas de chevauchement de voix.
Analyse prosodique et charge émotionnelle
Les LLM audio-natifs ne se contentent plus du texte transcrit ; ils écoutent le ton. Une phrase comme « C’est une excellente idée » peut exprimer un enthousiasme sincère ou un sarcasme mordant. En mesurant les variations de hauteur tonale (pitch), le rythme d’élocution, les hésitations et l’intensité dynamique en dB, l’outil taggue la composante émotionnelle réelle du dialogue.
Classification des événements sonores (Audio Event Detection)
Au-delà des voix, l’environnement sonore d’un plan révèle souvent l’essence de la scène. Les extracteurs audio identifient et isolent :
- Les bruits diégétiques critiques : Coups de feu, klaxon, sirène, porte qui claque, verre brisé, bruits de pas sur différents matériaux.
- L’acoustique de l’espace : Réverbération naturelle permettant de déduire la nature de la pièce (hangar désert, chambre étouffée, extérieur venté).
- La composante musicale : Présence de musique d’ambiance, détection du tempo (BPM), de la signature rythmique et de la tonalité harmonique.
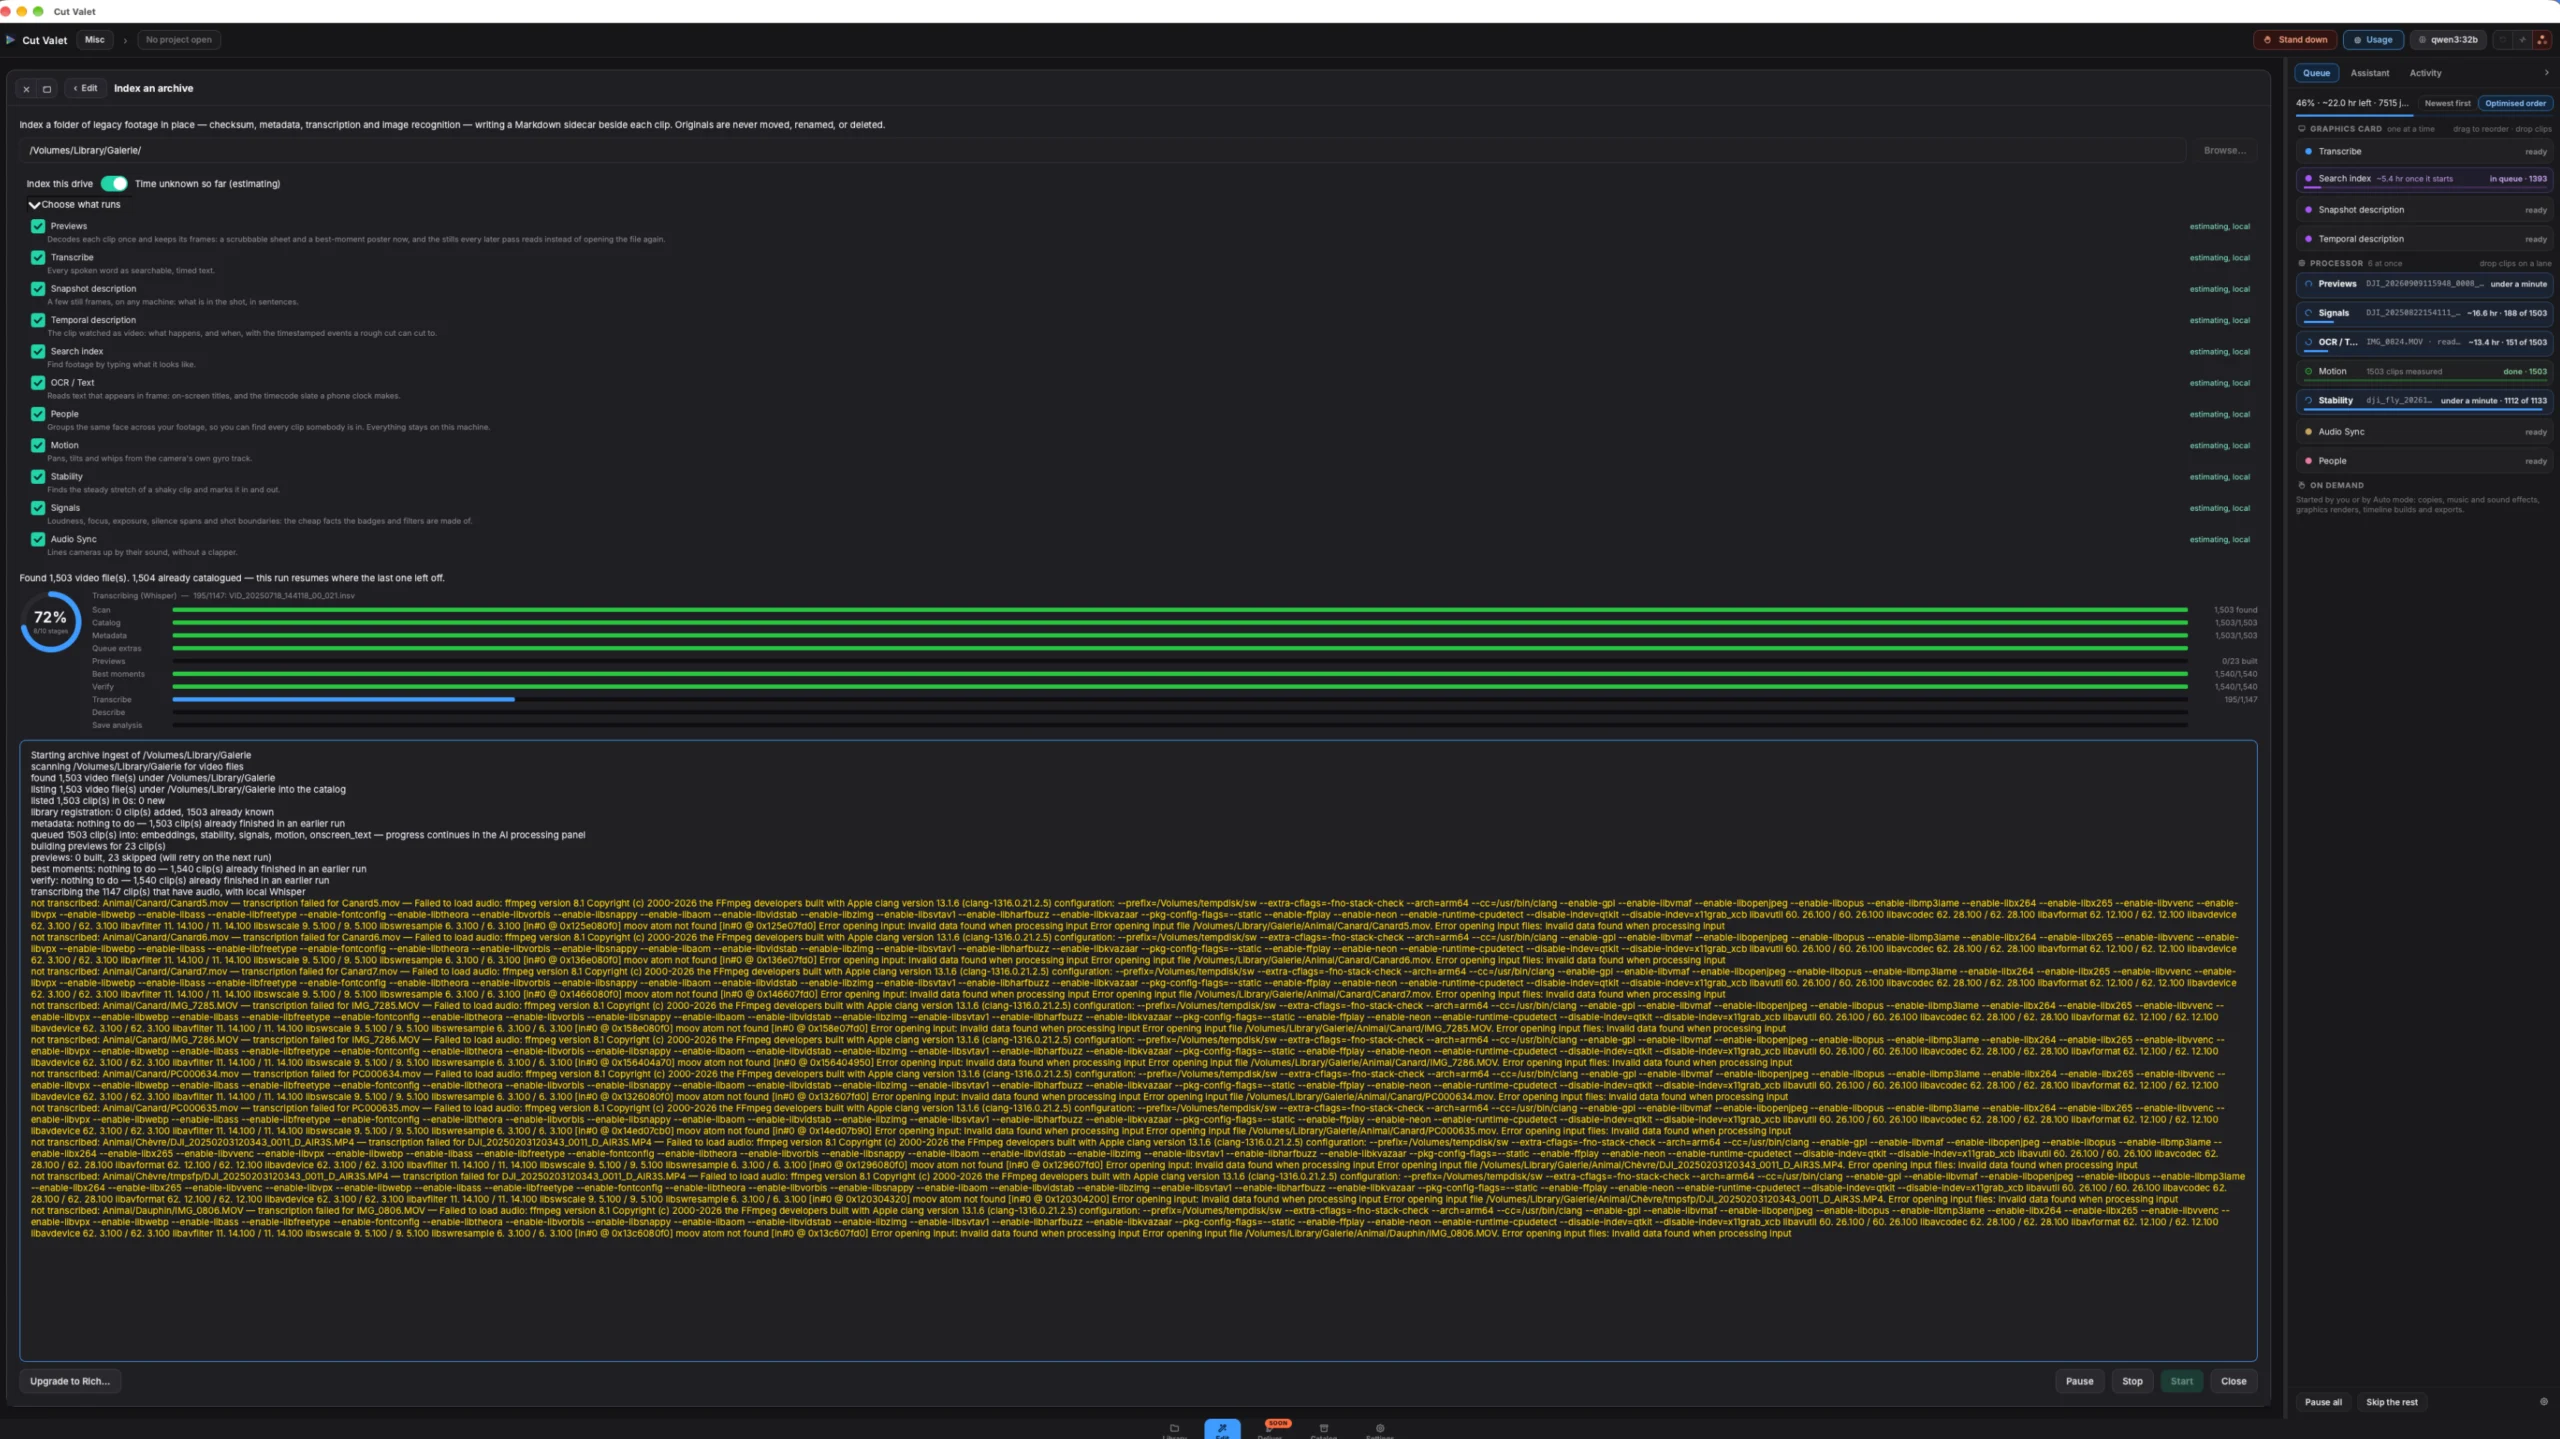
4. Au Cœur de Cut Valet : L’Indexation Intelligente et le Catalogage Automatisé
<p>L’application <strong>Cut Valet</strong> s’est imposée comme une référence pragmatique auprès des monteurs et des équipes de post-production en faisant le pont entre ces modèles d’IA complexes et les logiciels de montage non linéaire (NLE) comme DaVinci Resolve, Final Cut Pro ou Adobe Premiere Pro.</p>
<p>Plutôt que d’obliger l’utilisateur à naviguer dans des interfaces web tierces, Cut Valet intègre l’analyse IA directement au niveau du système de fichiers et de la timeline. Voici l’étendue de ce que le moteur extrait pour bâtir son catalogue :</p>
| Axe d’analyse | Données extraites par Cut Valet & LLM | Bénéfice direct en montage |
|---|---|---|
| Découpage de scènes (Scene Detection) | Détection des coupes franches (hard cuts), fondus enchaînés, fondus au noir et transitions par masque naturel. | Génération automatique de sous-plans et décomposition instantanée de masters consolidés. |
| OCR & Texte In-Frame | Lecture des inscriptions sur les claps de tournage, panneaux routiers, génériques, étiquettes, écrans d’ordinateurs visibles. | Attribution automatique de la scène, de la prise et du numéro de bobine sans saisie manuelle. |
| Description sémantique de plan | Échelle de plan (Gros plan, Plan moyen, Plan d’ensemble), angle de vue, règle des tiers, profondeur de champ (bokeh). | Filtrage ultra-rapide lors de la recherche d’inserts ou d’alternatives pour le montage d’un dialogue. |
| Palette & Colorimétrie | Identification de la température de couleur dominante, de l’exposition globale, du profil colorimétrique (Log, Rec.709, HDR). | Regroupement pré-étalonnage des plans tournés sous les mêmes conditions lumineuses. |
| Qualité technique & Anomalies | Détection de flou involontaire (misfocus), artefacts de compression, drops audio, bruit thermique excessif. | Élimination préventive des prises défectueuses avant même le démarrage de l’assemblage. |
5. Benchmark Comparatif des LLM pour l’Analyse Vidéo
Tous les modèles de fondation ne se valent pas lorsqu’il s’agit d’analyser un flux vidéo. Les architectures varient sensiblement en termes de méthode d’ingestion (vidéo native versus extraction de trames par proxy), de capacité de mémoire vive et de sensibilité à l’alignement temporel.
1. Gemini 1.5 Pro & Gemini 2.0 (Google) : Les Champions de la Compréhension Temporelle Longue
Google a pris une avance déterminante sur le traitement vidéo grâce à sa fenêtre native de 1 à 2 millions de tokens. Gemini ne se contente pas d’analyser un lot d’images fixes : il ingère des vidéos entières à raison de 1 trame par seconde (accompagnée de la piste audio synchronisée). Il excelle particulièrement dans le problème classique de « l’aiguille dans une botte de foin » (needle in a haystack) : retrouver un événement de deux secondes au milieu d’un enregistrement continu de 4 heures avec un timecode irréprochable.
2. GPT-4o (OpenAI) : La Finesse Sémantique et l’Interprétation Visuelle Rapide
Le modèle Omni d’OpenAI brille par son analyse holistique des scènes courtes et moyennes. Il se distingue par sa finesse de description psychologique des scènes de fiction (reconnaissance des micro-expressions des comédiens, déduction des sous-entendus narratifs) et une capacité d’OCR embarquée redoutable pour lire des textes déformés ou des reflets dans les miroirs.
3. Claude 3.5 Sonnet (Anthropic) : La Rigueur Logique et l’Organisation Structurée
Bien que Claude traite principalement la vidéo sous la forme de séquences de trames encodées, son intelligence déductive produit les métadonnées les plus propres pour la constitution de bases de données relationnelles. Utilisé en aval d’un pré-découpage, il génère des schémas JSON stricts d’une fiabilité exemplaire, prêts à être injectés dans des bases de données SQL ou des catalogues multimédias d’entreprise.
4. Modèles Open Weights Spécialisés (Video-LLaVA, LLaVA-NeXT, CogVLM2-Video)
Pour les productions soumises à de strictes clauses de confidentialité (NDAs) interdisant l’envoi de rushes vers des API cloud tierces, les modèles locaux auto-hébergés ont fait des progrès spectaculaires. Exécutés sur des stations de travail équipées de GPU puissants (NVIDIA RTX 4090 ou puces Apple Silicon unifiées), ils permettent une analyse confidentielle, sans frais d’abonnement au token, idéale pour les premières passes de dérushage.
6. Les Enjeux Techniques : Embeddings Vectoriels et Recherche Sémantique
L’indexation produite par Cut Valet et les LLM ne produit pas une simple liste statique de mots-clés. La véritable révolution réside dans l’utilisation des embeddings multimodaux.
Chaque plan découpé est projeté sous forme de vecteur mathématique de haute dimension (par exemple via CLIP ou des modèles de plongement de texte et d’image unifiés). Dans cet espace vectoriel, un concept visuel et sa description textuelle partagent des coordonnées très proches.
Ce mécanisme autorise des recherches qui étaient jusqu’alors totalement impossibles dans un logiciel de montage :
- Recherche métaphorique : Taper « Sentiment de solitude écrasante dans une métropole moderne » permet de faire remonter des plans d’ensemble froids montrant un personnage isolé au milieu d’une foule en contre-plongée, même si personne n’a explicitement tapé le mot « solitude » dans les tags du plan.
- Recherche par similarité visuelle (Query by Example) : Vous sélectionnez un plan dont la composition vous plaît et demandez : « Trouve-moi tous les rushes du tournage qui possèdent une colorimétrie et une dynamique de cadre équivalentes. »
- Recherche d’actions temporelles composées : « Le suspect regarde à gauche, hésite, puis s’enfuit en courant vers l’arrière-plan. »
7. Perspectives : Vers le Prémontage Automatique sur la Timeline
Le catalogage n’est que la première phase de la transformation des métiers de l’image. Dès lors qu’un outil comme Cut Valet dispose d’un index complet mêlant le timecode, le mouvement, l’audio, les intentions émotionnelles et la qualité technique de chaque prise, la frontière entre l’indexation et le montage actif s’estompe.
Les workflows contemporains permettent déjà de générer des fichiers d’échange universels (EDL, XML Final Cut Pro, AAF Avid). Demain, il suffira de fournir un script ou une trame narrative en langage naturel pour que le système assemble un « Radio Edit » ou un « Assembly Cut » propre et cohérent en quelques secondes :
- L’IA sélectionne les meilleures prises en écartant les hésitations et les défauts de netteté.
- Elle alterne intelligemment entre plans larges et plans serrés en respectant la grammaire de l’axe des 180 degrés (déduite des vecteurs de regard et de position).
- Elle synchronise les coupes sur les silences et les temps forts musicaux détectés par l’analyse acoustique.
Loin de déposséder le monteur de sa créativité, cette convergence entre analyse spatio-temporelle et modèles de langage élimine les tâches fastidieuses de tri et de recherche documentaire. Elle redonne au créateur son temps d’attention le plus précieux : celui du rythme, du sens et de l’émotion.